Sinds 10 september kun je een AI je telefoon laten opnemen voor vijf dollarcent per minuut, omgerekend ruim vier eurocent. OpenAI bracht die dag gpt-live-1 naar de API, het stemmodel dat sinds juli al in ChatGPT zit en dat praat en luistert op hetzelfde moment. Val hem halverwege een zin in de rede en hij stopt, zoals een collega dat ook zou doen. Maar dat tarief geldt alleen voor de stem. Wat er volgens de eigen documentatie van OpenAI nog bij komt, bepaalt of een AI aan je klantenlijn echt goedkoper uitvalt dan de medewerker die nu opneemt.
Wat kun je hiermee bouwen dat eerst niet kon?
Een telefoonlijn die opneemt, meepraat en ondertussen je eigen systemen raadpleegt, zonder dat de beller een stilte hoort. Het model heet gpt-live-1 en draaide sinds 8 juli al onder ChatGPT Voice. Nu kun je hem zelf inbouwen.
Het verschil met de spraakbots die je kent zit in de timing. Een klassieke spraakbot werkt als een portofoon: jij praat, je laat los, dan begint hij. GPT-Live-1 werkt als een telefoon. Je kunt door elkaar heen praten, hij zegt af en toe "mm-hm" om te laten merken dat hij luistert, en hij houdt zijn mond als jij nadenkt. OpenAI heeft de zogeheten turn detector, het stukje software dat bepaalt wanneer jouw beurt voorbij is, helemaal uit het audiopad gehaald.
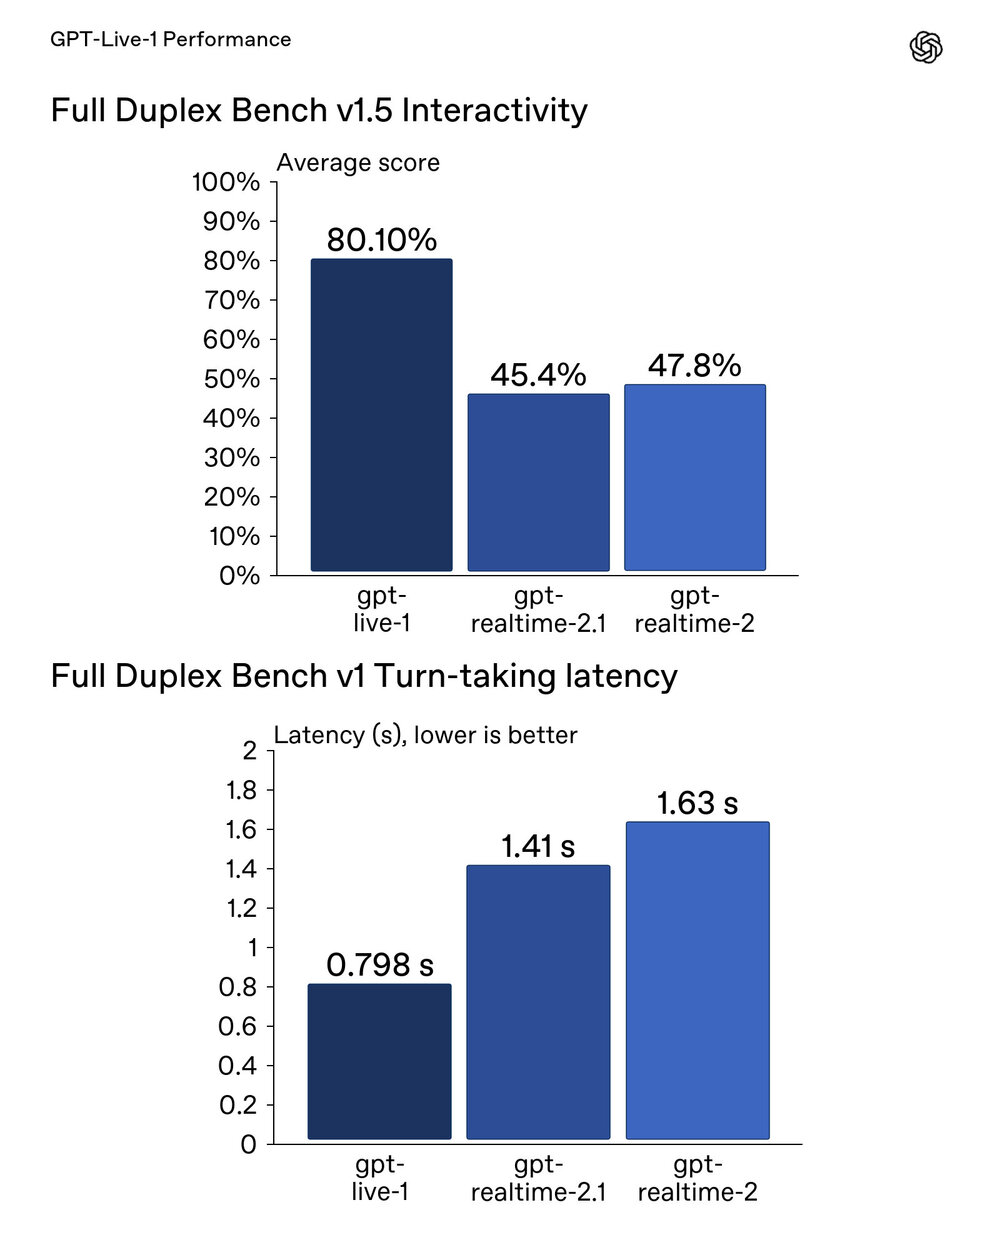
Het effect is meetbaar. Op Full Duplex Bench, de test die meet hoe goed een stemmodel beurtwisselingen aanvoelt, scoort gpt-live-1 volgens OpenAI 30 procentpunt hoger dan het vorige gpt-realtime-2.1. Taalapp Speak, een van de eerste gebruikers, zag het aantal keren dat de AI iemand in de rede viel met bijna 80 procent dalen. Een andere klant hield na de overstap 23.000 regels code minder over, omdat de losse onderdelen voor spraakherkenning en spraaksynthese eruit konden.
Het model spreekt in twaalf stemmen, verspreid over accenten, dialecten en talen. Het draait alleen op het nieuwe eindpunt v1/live/sessions, dus niet via Chat Completions of de Assistants-API. Op het gratis niveau werkt het niet. Hoeveel gesprekken je tegelijk mag voeren hangt af van je gebruikstier: 25 gelijktijdige sessies op tier 1, 500 op tier 5.
De stem en het denkwerk zitten nu los van elkaar
GPT-Live-1 voert het gesprek, een tweede model doet het denkwerk. OpenAI noemt dat delegatie, en het is de belangrijkste verandering onder de motorkap.
In de oude opzet deed één model alles: luisteren, redeneren, tools aanroepen, antwoorden. Nu kies je het achterliggende model apart. Dat mag GPT-6 Astra zijn, een lichter model, of een systeem van een andere leverancier. Terwijl dat model een order opzoekt of een agenda checkt, blijft de stem gewoon doorpraten. De beller hoort geen wachtmuziek en geen "een moment alstublieft".
Even voor de beeldvorming: je schrijft dus twee prompts. Eentje voor de stem, kort, over toon en wanneer hij moet doorschakelen naar de achterkant. En eentje voor het achterliggende model, waar je bedrijfsregels, tools en procedures in zet. OpenAI waarschuwt expliciet dat het stemmodel een klein contextvenster heeft. Prop je daar je hele klantenservicehandboek in, dan gaat het mis.
Wat kost een gesprek van vier minuten?
Ongeveer 22 eurocent, als je de rekenvoorbeelden van OpenAI zelf doortrekt. De documentatie rekent een sessie van 90 seconden voor: 7,5 dollarcent voor de stem plus 2 dollarcent voor het achterliggende model, samen 9,5 dollarcent. Schaal dat naar vier minuten en je zit rond de 25 dollarcent, oftewel 22 eurocent tegen de koers van deze week. Inclusief btw kom je op zo'n 26 cent.
Duizend van die gesprekken kosten je dan ruwweg 220 euro exclusief btw. Ter vergelijking: McKinsey en Salesforce komen in hun gezamenlijke cijfers uit op 0,62 dollar per AI-afgehandeld klantcontact tegenover 7,40 dollar voor een gesprek met een medewerker, cijfers die ook zijn verzameld in de AI-klantenservicecijfers van TheAIDaily.
De prijslijst zelf is kort. De rekening bestaat uit zes posten.
| Kostenpost | Wat je betaalt | Detail |
|---|---|---|
| Spraaksessie | 0,05 dollar per minuut | Per seconde afgerekend, niet afgerond naar hele minuten |
| Achterliggend model | De gewone tokenprijs | Hangt af van welk model je eraan hangt |
| Stilte en wachttijd | Vol tarief | Telt mee als actieve sessietijd |
| Opstarten via WebRTC | 15 seconden vooraf | Wordt verrekend zodra de sessie loopt |
| Telefonie | Aparte rekening | Via Twilio, Telnyx, LiveKit of Daily en Pipecat |
| Microfoon dempen | Vol tarief | Dempen sluit de sessie niet, de meter loopt door |
Welke posten staan niet op de prijspagina?
Stilte, opstarttijd en je telefonieprovider. Die drie bepalen samen het verschil tussen je schatting en je factuur.
OpenAI is er op de kostenpagina voor spraaktoepassingen duidelijk over: actieve sessietijd is alle tijd waarin de beller praat, waarin de assistent praat, waarin het allebei stil is, en waarin de achterkant staat te werken. De meter loopt dus ook als je klant even zijn ordernummer zoekt. Wie de microfoon dempt en denkt dat het daarmee stopt, komt bedrogen uit.
Er zit ook een startpost in. Een verzoek om een WebRTC-sessie aan te maken kost meteen 15 seconden aan spraakduur. Dat bedrag wordt teruggerekend zodra de sessie echt loopt, dus je betaalt niet dubbel, maar bij een applicatie die telkens opnieuw verbinding maakt tikt het wel aan.
En dan je telefoonlijn zelf. Die loopt via een provider als Twilio of Telnyx, en die stuurt een eigen rekening. OpenAI levert alleen het gesprek.
De documentatie geeft er ook een besparingstip bij, en die is verrassend praktisch: sluit de spraaksessie als je achterkant aan een langere klus begint, en open een nieuwe als het resultaat er is. Dat scheelt vijf dollarcent per minuut stilstand. Overigens hoort de assistent ook welke toets de beller indrukt, van 0 tot 9 en van A tot en met D. Die laatste vier toetsen zitten al decennia op vrijwel geen enkel toestel meer.
Hoe zet je hem op je eigen telefoonlijn?
Via SIP, het protocol waar je zakelijke telefonie waarschijnlijk al op draait. In vijf stappen ziet dat er zo uit.
- Zet SIP aan voor je project en laat je telefonieprovider de trunk naar dat project routeren. Zonder die twee dingen komt er geen gesprek binnen.
- Configureer een webhook voor het type
live.transport.incoming. Controleer de handtekening en gooi dubbele meldingen eruit, want een bevestiging van ontvangst is nog geen aangenomen gesprek. - Neem op of weiger. Opnemen doe je met een POST-verzoek naar
/v1/live/sessions/{session_id}/accept, met daarin de stem en de delegatiemodus. Weigeren doe je met een SIP-statuscode, bijvoorbeeld 486 voor bezet. - Hang je eigen backend eraan via een sideband-websocket op
wss://api.openai.com/v1/live/sessions/{session_id}/attach. Daar komen je transcripties, delegaties en tool-aanroepen langs. - Houd de gespreksprompt kort. Alles wat met procedures te maken heeft, hoort in de prompt van het achterliggende model.
Het verzoek om op te nemen uit stap 3 ziet er in de documentatie zo uit:
POST /v1/live/sessions/{session_id}/accept

{
  "session": {
    "type": "live",
    "model": "gpt-live-1",
    "instructions": "Je neemt een binnenkomend supportgesprek aan.",
    "audio": { "output": { "voice": "marin" } },
    "delegation": { "type": "client" }
  }
}
En dit is een Nederlandstalige startprompt voor de stem zelf, gebouwd op het sjabloon dat OpenAI in zijn handleiding voor prompts meegeeft. De eerste regel over de AI-melding staat er niet voor niets in, daarover verderop meer.
Je bent Sanne, de telefonische assistent van [bedrijf].
Zeg bij het opnemen dat je een AI-assistent bent.
Spreek Nederlands, rustig en duidelijk, en niet overdreven vrolijk.
Is de beller geïrriteerd, benoem dat kort en ga door naar de volgende stap.

Backchannel-beleid: gebruik af en toe een kort "mm-hm", maar praat niet door het antwoord heen.

Onderbrekingsbeleid: stop met praten zodra de beller je onderbreekt, en luister.

Delegatiebeleid:
Wat de backend kan:
- Afspraken: beschikbare tijden opzoeken, afspraken maken, wijzigen of annuleren.
- Orders: de status van een order opzoeken.

Delegeer naar de backend wanneer:
- De beller naar beschikbaarheid vraagt of een afspraak wil maken, wijzigen of annuleren.
- De beller de status van een order wil weten.
- Een correctie verandert wat er al gevraagd is.

Delegeer niet wanneer:
- Je het antwoord al uit het gesprek kent.
- Je eerst een korte verduidelijking nodig hebt.

Delegeer voordat je een antwoord geeft dat van de backend afhangt.
Gok het resultaat niet terwijl je wacht.
Praat hij goed Nederlands?
Niet gegarandeerd, en OpenAI zegt dat zelf. Bij de lancering erkent het bedrijf dat een deel van de niet-Engelse talen nog een niet-native accent heeft of hier en daar hapert. Er zijn twaalf stemmen, verdeeld over accenten en talen, maar een stem kiezen is iets anders dan een accent krijgen.
“Een stemkeuze garandeert geen regionaal accent.”
OpenAI, handleiding voor het prompten van GPT-Live
Wat volgens diezelfde handleiding wél helpt: schrijf je prompt in de taal die je wilt horen. Wil je dat de assistent Nederlands spreekt, dan schrijf je zijn instructies en voorbeeldzinnen in het Nederlands. Staat er een naam in die vaak verkeerd gaat, geef dan de uitspraak mee.
Test het in ieder geval zelf voordat je hem op je hoofdnummer zet. Laat hem een Nederlandse straatnaam teruglezen, een postcode met letters, en een bedrag met komma's. Daar gaan spraakmodellen in het Nederlands het vaakst onderuit. Google rekende eerder dit jaar drie dollarcent per minuut voor Nederlandstalige spraaksynthese met Gemini Flash, al is dat voorlezen en geen gesprek.
Nog een detail dat je in je ontwerp moet meenemen: het stemmodel zelf weet niets van na 31 juli 2025. Actuele kennis moet uit het achterliggende model of uit je eigen systemen komen. Die kale opzet is bewust: het denkwerk hoort aan de achterkant.
Wat de AI Act vanaf 2 augustus van je vraagt
Je beller moet weten dat hij met een AI praat. Sinds 2 augustus 2026 geldt de transparantieplicht uit artikel 50 van de EU AI Act: wie een systeem inzet dat rechtstreeks met mensen communiceert, moet dat kenbaar maken. Voor een chatbot in een venster is dat een labeltje. Aan de telefoon is het een zin bij het opnemen, en die zin schrijf je dus in je prompt. Eerder verscheen op TheAIDaily een uitleg van wat die transparantieplicht precies van je vraagt.
Dat is geen overbodige formaliteit, want het publiek is er nog niet aan gewend. Uit onderzoek van SurveyMonkey blijkt dat 79 procent van de consumenten liever een mens aan de lijn heeft, terwijl volgens Salesforce inmiddels een kwart van de Nederlandse klantenservicecases door AI wordt afgehandeld. Hoe je het aankondigt, weegt in Nederland dus zwaarder dan hoe goed de stem klinkt.
OpenAI bouwde zelf ook een paar remmen in. Volgens het veiligheidsrapport bij het model wordt er realtime meegeluisterd en kan een onveilig gesprek automatisch worden onderbroken. Stemklonen en imitaties van bestaande personen weigert het model standaard.
Wanneer vier cent per minuut zich terugverdient
Bij korte, herhaalbare gesprekken met veel volume. Denk aan het verzetten van afspraken, de status van een order, openingstijden, een bevestiging die je toch al uitbelt. Daar is een gesprek van twee minuten genoeg, en telt elke minuut die je een medewerker bespaart.
Het werkt slecht bij gesprekken waarin één misverstand duur is: een schadeclaim, een medische vraag, een boze klant die wil opzeggen. Ook als je klant halverwege alsnog een mens wil, moet die overdracht soepel zijn, anders heb je de irritatie alleen maar verplaatst.
Reken in je businesscase met sessieduur, niet met spreektijd. Dat is de fout die het snelst gemaakt wordt: een gesprek van vier minuten waarin twee minuten wordt gepraat, kost je nog steeds vier minuten. En begin klein. Zet hem eerst op je uitgaande bevestigingsbelletjes, waar de schade van een misverstand beperkt blijft, en pas daarna op de lijn waar je klanten binnenkomen. Wil je dit soort releases sneller voorbij zien komen, dan staan ze elke ochtend in de dagelijkse AI-nieuwsbrief van TheAIDaily.
In juni had het model nog een codenaam. Toen werkte OpenAI aan een ChatGPT-stem die tegelijk praat en luistert. Drie maanden later staat hij op je telefoonlijn.
Bron: OpenAI, "Build more natural voice experiences with GPT-Live-1 in the API", 10 september 2026, aangevuld met de modelpagina en de ontwikkelaarsdocumentatie van gpt-live-1.